

Duplikacja treści, czyli duplicate content, występuje wtedy, gdy identyczna lub bardzo podobna zawartość pojawia się pod kilkoma adresami URL. Nie zawsze oznacza to karę od Google, ale może utrudniać wybór właściwej wersji strony i osłabiać SEO. W artykule wyjaśniamy, skąd bierze się duplikacja, jak ją wykryć i jak ją naprawić za pomocą canonicali, przekierowań 301 i innych rozwiązań.
Co to jest duplikacja treści?
Duplikacja treści to sytuacja, w której identyczna lub bardzo podobna treść występuje pod więcej niż jednym adresem URL, zarówno w obrębie tej samej domeny lub w różnych serwisach. Może obejmować zarówno pełne kopie stron, jak i duże fragmenty tekstu, opisy produktów, strony kategorii czy różne warianty tego samego adresu URL.
W obrębie domeny dla wyszukiwarki dwoma wersjami tej samej treści mogą być przykładowo adresy:
- http://example.com/oferta
- https://example.com/oferta
albo:
- https://example.com/produkt
- https://example.com/produkt?color=black
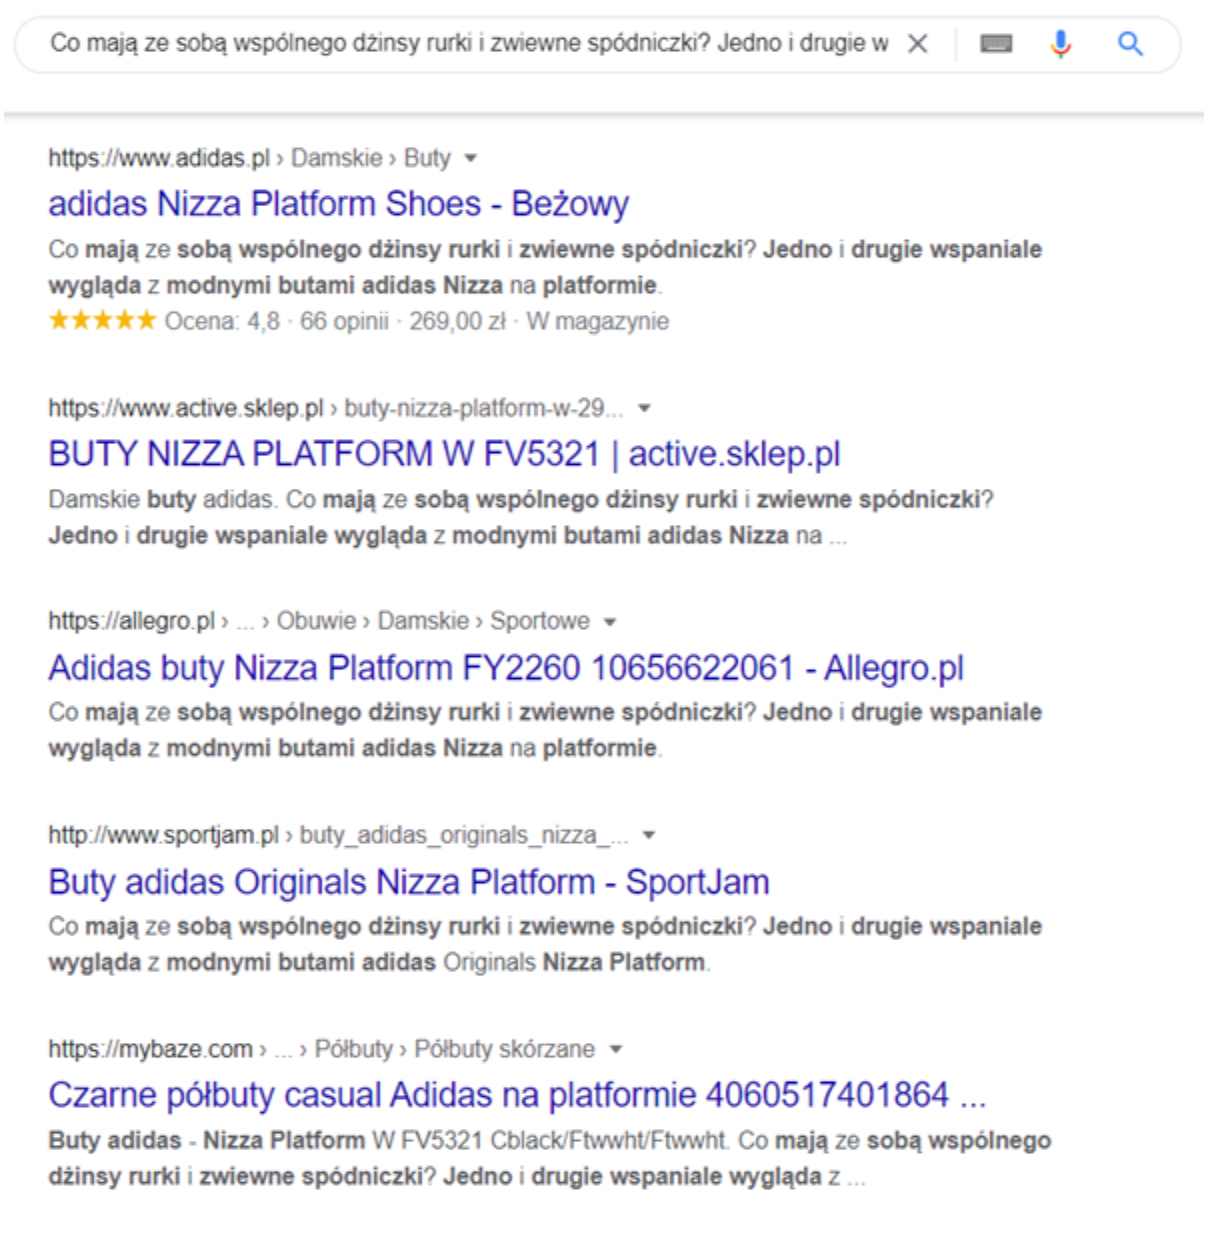
Użytkownik może zobaczyć niemal identyczną stronę, podczas gdy robot wyszukiwarki otrzymuje dwa różne adresy URL. Google jako typowe przyczyny powielania treści wskazuje między innymi wersje HTTP i HTTPS, warianty regionalne, wersje dla różnych urządzeń, filtrowanie i sortowanie oraz przypadkowo dostępne środowiska demonstracyjne. Duplicate content nie ogranicza się jednak do problemów technicznych. Do duplikacji może dojść również wtedy, gdy sklep korzysta z opisów produktów dostarczonych przez producenta, kilka podstron ma prawie identyczny tekst albo cały artykuł zostanie skopiowany przez inną witrynę.
Czy duplikacja treści szkodzi SEO?
Sama obecność podobnych lub powtarzających się treści nie oznacza automatycznie kary. Google wprost informuje, że duplicate content co do zasady nie jest naruszeniem zasad dotyczących spamu. Nie znaczy to jednak, że problem można ignorować. Jeżeli ta sama treść jest dostępna pod wieloma adresami, Google musi ustalić, który z nich najlepiej reprezentuje dany materiał. Wyszukiwarka grupuje podobne strony i wybiera adres kanoniczny. Może przy tym wybrać inną wersję niż ta, na której zależy właścicielowi witryny.
W praktyce rozbudowana duplikacja może prowadzić do kilku problemów:
| Problem | Co może się wydarzyć? |
| Niewłaściwy URL w wynikach | Google może uznać za kanoniczny inny adres niż oczekiwany |
| Rozproszenie sygnałów | Linki i inne sygnały mogą trafiać do kilku wersji tej samej strony zamiast jednej |
| Niepotrzebne skanowanie | Robot odwiedza liczne warianty URL zamiast ważniejszych podstron |
| Trudniejsza analiza danych | Ruch i linki są rozłożone pomiędzy kilka adresów |
| Problemy w e-commerce | Filtry, sortowania i warianty mogą tworzyć bardzo dużą liczbę podobnych stron |
| Mniejsza kontrola nad SERP | W wynikach może pojawić się wersja mniej atrakcyjna dla użytkownika |
Problem budżetu crawlowania ma największe znaczenie w rozbudowanych witrynach. Niewielki blog nie musi panikować z powodu kilku podobnych adresów, ale w sklepie mającym setki tysięcy URL-i niekontrolowane filtry i parametry mogą generować ogromną liczbę stron do przeskanowania.
Duplikacja wewnętrzna i zewnętrzna – czym się różnią?
Duplikację można podzielić na dwa podstawowe rodzaje.
Duplikacja wewnętrzna
Duplikacja wewnętrzna występuje w obrębie tej samej witryny. Oznacza to, że identyczna lub bardzo podobna treść znajduje się pod kilkoma adresami należącymi do jednej domeny. Przykładem może być produkt dostępny jednocześnie pod adresem zależnym od kategorii i pod osobnym adresem produktowym. Innym przypadkiem są wersje strony z www i bez www, HTTP i HTTPS albo adresy z parametrami sortowania. To właśnie na ten rodzaj duplikacji właściciel strony ma zwykle największy wpływ.
Duplikacja zewnętrzna
Duplikacja zewnętrzna występuje wtedy, gdy ta sama treść pojawia się w różnych domenach. Najbardziej typowy przykład to opisy produktów pochodzące od producenta. Jeżeli ten sam opis trafia do kilkudziesięciu sklepów, wszystkie publikują niemal identyczny materiał. Drugim przypadkiem jest kopiowanie artykułów lub innych materiałów bez zgody autora. Powielona treść może również powstać w wyniku legalnej syndykacji, np. gdy jeden artykuł jest za zgodą autora publikowany w kilku serwisach.
Samo oznaczenie cytatu znacznikiem <blockquote> nie usuwa problemu duplikacji. Znacznik określa semantycznie cytowaną treść, ale nie sprawia, że wyszukiwarka przestaje ją widzieć. Dlatego cytaty powinny być rozsądnej długości i uzupełnione własnym komentarzem lub analizą.
Jakie są najczęstsze przyczyny duplikacji treści?
Duplicate content bardzo często nie jest wynikiem celowego kopiowania tekstu. Źródłem problemu może być sposób działania CMS-a, niewłaściwa konfiguracja serwera albo struktura sklepu internetowego.
| Przyczyna | Przykład |
| HTTP i HTTPS | Ta sama strona działa w obu protokołach |
| www i bez www | Dostępne są dwa warianty domeny |
| Dodatkowe końcówki | /, /index.php, /index.html prowadzą do tej samej treści |
| Parametry URL | ?sort=price, ?color=black, identyfikatory sesji |
| Filtrowanie | Każda kombinacja filtrów tworzy nowy adres |
| Warianty produktów | Kolor lub rozmiar tworzy podobną stronę produktu |
| Opisy producenta | Ten sam tekst znajduje się w wielu sklepach |
| Kategorie | Kilka kategorii otrzymuje niemal identyczny opis |
| Środowisko testowe | Wersja stagingowa trafia do indeksu |
| Wersje regionalne | Podobne strony nie mają prawidłowego hreflang |
| Kopie zewnętrzne | Inna domena publikuje ten sam artykuł |
| Automatycznie tworzone strony | CMS generuje wiele wariantów o małej wartości |
Przyjrzyjmy się najważniejszym przypadkom bliżej.
Nieprawidłowe wdrożenie HTTPS
Po migracji z HTTP na HTTPS stara wersja adresu nie powinna nadal funkcjonować jako osobna, dostępna strona. Jeśli zarówno:
- http://example.com/oferta
- https://example.com/oferta
zwracają pełną treść, powstają dwa adresy reprezentujące tę samą stronę. W takim przypadku standardowym rozwiązaniem jest stałe przekierowanie ze starej wersji na HTTPS. Podobną zasadę można zastosować przy uporządkowaniu wersji z www i bez www.
Kilka adresów prowadzących do tej samej strony
CMS może udostępniać stronę główną jako:
- https://example.com
- https://example.com/index.php
- https://example.com/index.html
Dla użytkownika różnica jest niewielka, ale technicznie są to różne adresy. Jeżeli dodatkowe warianty nie są potrzebne, najlepiej sprowadzić je stałymi przekierowaniami do jednego preferowanego URL-a i właśnie jego używać w linkowaniu wewnętrznym.
Parametry URL, filtry i sortowanie
Problem szczególnie często dotyczy sklepów internetowych. Jedna kategoria może występować jako:
- /buty
- /buty?sort=price
- /buty?color=black
- /buty?color=black&size=42
Nie każdy taki adres jest automatycznie błędem. Filtry mogą być wartościowe dla użytkowników, a niektóre strony filtrowane mogą odpowiadać na realne zapytania z wyszukiwarki. Problem pojawia się wtedy, gdy system bez kontroli generuje tysiące kombinacji zawierających praktycznie tę samą listę produktów. Strategię indeksacji filtrów warto więc ustalać na podstawie użyteczności i potencjału wyszukiwania, a nie według zasady, że każdy parametr powinien być indeksowany albo blokowany.
Problemy z paginacją
Paginacja sama w sobie nie jest duplikacją, którą należy „naprawiać” przez wskazanie wszystkich kolejnych stron jako kopii strony pierwszej. Google rekomenduje, aby poszczególne strony paginacji miały własne adresy URL i własne canonicale wskazujące na siebie. Nie należy ustawiać pierwszej strony kategorii jako canonicala dla całego stronicowania.
Może natomiast pojawić się problem, gdy CMS tworzy dwa różne adresy pierwszej strony, np.:
- /kategoria
- /kategoria?page=1
Jeżeli pokazują dokładnie tę samą zawartość, warto ujednolicić sposób linkowania i konsekwentnie używać jednego wariantu.
Zaindeksowana wersja deweloperska
Środowisko testowe nie powinno być publicznym duplikatem działającej strony. Najlepszym zabezpieczeniem wersji testowej jest ograniczenie dostępu, np. uwierzytelnieniem. Jeśli środowisko może być publicznie dostępne, można dodatkowo zastosować odpowiednie mechanizmy kontroli indeksowania.
Samo dodanie już zaindeksowanej strony do robots.txt nie jest uniwersalnym rozwiązaniem. Zablokowany adres nie może zostać przeskanowany, a sam URL nadal może pojawić się w wynikach wyszukiwania bez opisu. Jeżeli środowisko testowe nie jest już potrzebne, odpowiednim rozwiązaniem może być przekierowanie do właściwych adresów produkcyjnych. Przy aktywnym środowisku trzeba natomiast zadbać przede wszystkim o kontrolę dostępu i brak indeksacji.
Duplikacja treści w e-commerce
Sklepy internetowe są szczególnie podatne na duplicate content. Wynika to z dużej liczby produktów, wariantów, kategorii, filtrów oraz automatycznie generowanych adresów. Najczęściej problem rozpoczyna się od opisów producenta. Ich użycie jest wygodne, ale ten sam tekst może pojawić się w dziesiątkach innych sklepów.
Nie oznacza to, że koniecznie trzeba przepisywać od zera każdy parametr techniczny. Warto przede wszystkim dodać informacje, które rzeczywiście pomagają klientowi: własny opis, poradę dotyczącą zastosowania produktu, odpowiedzi na pytania, opinie użytkowników, zdjęcia, porównanie wariantów lub wskazówki dotyczące wyboru. W przypadku tysięcy produktów priorytet można nadać tym stronom, które generują ruch, sprzedaż, mają wartościowe backlinki albo największy potencjał wyszukiwania.
Kolejnym wyzwaniem są warianty produktu. Kolor, rozmiar czy wyposażenie mogą generować osobne adresy. Google dopuszcza oddzielne URL-e dla wariantów, ale sposób używania canonicali powinien być spójny z tym, które strony faktycznie chcemy indeksować.
Duplikacja title i meta description
Powtarzające się title i meta description nie są dokładnie tym samym problemem co duplikacja głównej treści strony. Nadal warto jednak je kontrolować. Jeżeli kilkadziesiąt kategorii ma title “Buty sportowe – sklep” trudniej jasno zakomunikować użytkownikowi i wyszukiwarce, czym różnią się poszczególne strony. Lepsze rozwiązanie to tworzenie tytułów wynikających z zawartości konkretnego URL-a, np.:
- Buty do biegania męskie – sklep
- Damskie buty trekkingowe – sklep
- Buty sportowe dla dzieci – sklep
Podobnie warto podejść do meta description. Nie trzeba obsesyjnie tworzyć unikalnego opisu dla każdej technicznej strony serwisu, ale najważniejsze strony przeznaczone do pozyskiwania ruchu powinny mieć jasno określony temat i cel.
Duplikacja treści a kanibalizacja – czy to to samo?
Nie, ponieważ duplikacja treści oznacza, że pod kilkoma adresami znajduje się identyczna lub bardzo podobna zawartość. Kanibalizacja słów kluczowych występuje natomiast wtedy, gdy kilka podstron konkuruje o tę samą intencję wyszukiwania. Ich teksty mogą być całkowicie różne.
Przykładowo sklep może mieć dwa poradniki:
- /jak-wybrac-buty-do-biegania
- /wybor-butow-do-biegania
Jeżeli oba odpowiadają na dokładnie to samo pytanie i są optymalizowane pod tę samą potrzebę użytkownika, może wystąpić kanibalizacja mimo braku literalnie skopiowanej treści. Z kolei dwa adresy URL tego samego produktu mogą być przypadkiem klasycznej duplikacji technicznej. Rozróżnienie jest ważne, ponieważ rozwiązanie zależy od źródła problemu.
Jak wykryć duplikację treści?
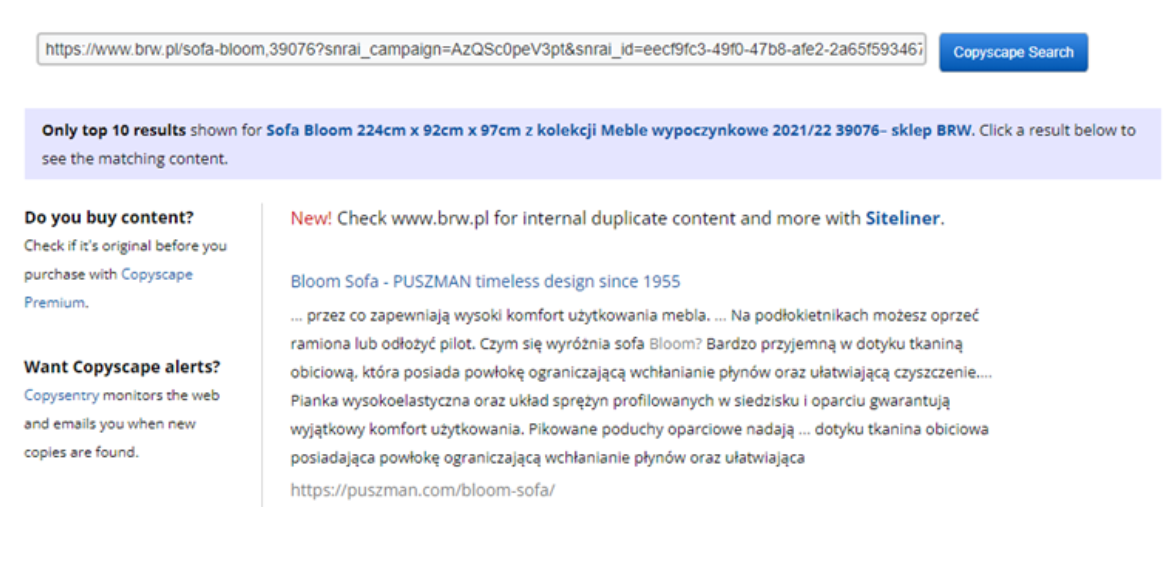
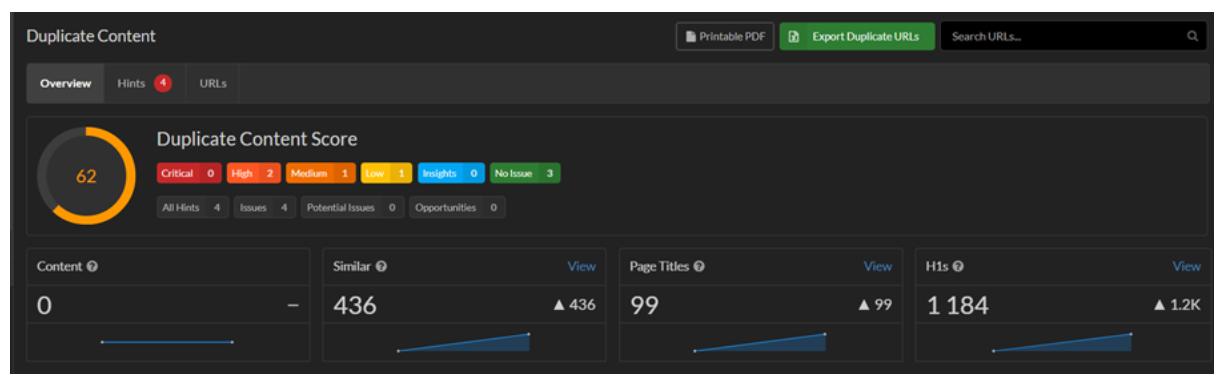
Nie istnieje jedno narzędzie, które znajdzie wszystkie możliwe typy duplikacji. Najlepsze efekty daje połączenie crawlera, danych z Google Search Console i narzędzi do sprawdzania kopii zewnętrznych.
| Co chcesz znaleźć? | Przydatne narzędzia |
| Duplikację wewnętrzną | Sitebulb, Screaming Frog, Siteliner |
| Kopie w innych domenach | Copyscape, Google, narzędzia antyplagiatowe |
| Problemy z canonicalami | Google Search Console, crawler SEO |
| Powtarzające się title i description | Sitebulb, Screaming Frog |
| Problemy z indeksacją | Google Search Console |
| Kanibalizację | Google Search Console, Senuto, Semstorm |
| Linki do duplikujących się URL-i | Majestic |
W przypadku niewielkiej liczby artykułów można również użyć wyszukiwarki Google. Wystarczy wybrać charakterystyczny fragment tekstu, umieścić go w cudzysłowie i sprawdzić, czy pojawia się również pod innymi adresami.
Przy duplikacji technicznej ważniejsze od samego porównania tekstów może być sprawdzenie, jakie adresy Google faktycznie zna. W Google Search Console warto zwrócić uwagę na informacje dotyczące adresu kanonicznego wskazanego przez użytkownika i wybranego przez Google.
Jeżeli Google regularnie wybiera inną wersję niż oczekiwana, jest to sygnał do sprawdzenia canonicali, przekierowań, sitemap, linkowania wewnętrznego i jakości poszczególnych wersji.
Jak naprawić duplikację treści?
Sposób naprawy powinien wynikać z przyczyny problemu. Nie ma jednego mechanizmu, który należy wdrożyć we wszystkich przypadkach.
Przekierowanie 301
Stałe przekierowanie jest dobrym rozwiązaniem wtedy, gdy jedna wersja strony nie jest już potrzebna. Dotyczy to między innymi migracji HTTP → HTTPS, uporządkowania www/bez www, starych adresów po zmianie struktury URL czy zbędnych wersji /index.php.
Przekierowanie jest dla Google silnym sygnałem wskazującym adres docelowy jako wersję kanoniczną. Nie należy natomiast przekierowywać masowo wszystkich podobnych stron do jednego przypadkowego URL-a. Adres docelowy powinien rzeczywiście odpowiadać treści i intencji strony źródłowej.
Link kanoniczny rel=”canonical”
Jeżeli kilka adresów musi pozostać dostępnych dla użytkowników, ale chcemy wskazać preferowaną wersję dla wyszukiwarki, można zastosować canonical. Przykład: <link rel=”canonical” href=”https://example.com/produkt” />
Canonical jest silnym sygnałem, ale nie stanowi bezwzględnego nakazu. Google może wskazać inną wersję, jeżeli pozostałe sygnały są ze sobą sprzeczne. Dlatego nie wystarczy wstawić tagu i zapomnieć o problemie. Jeżeli canonical wskazuje adres A, a linkowanie wewnętrzne prowadzi głównie do adresu B, sitemap zawiera B, a część przekierowań również kończy się na B, wyszukiwarka otrzymuje niespójne informacje.
Paramter “noindex“
“noindex” warto stosować w przypadku stron, które mogą być dostępne dla użytkownika, ale nie powinny znajdować się w wynikach wyszukiwania. Mogą to być przykładowo niektóre wyniki wyszukiwania wewnętrznego, techniczne archiwa lub wybrane warianty filtrów.
Nie należy jednak używać noindex zamiennie z canonicalem. Jeżeli celem jest konsolidacja dwóch duplikujących się stron i przeniesienie sygnałów do jednego adresu, canonical albo przekierowanie będą zazwyczaj bardziej logicznym rozwiązaniem.
Redakcja treści
Jeżeli kilka stron ma pełnić różne funkcje i każda z nich powinna pojawiać się w Google, samo zastosowanie canonicala nie rozwiązuje problemu biznesowego. Trzeba sprawić, aby strony rzeczywiście się od siebie różniły.
Dotyczy to między innymi opisów kategorii, landing page’y lokalnych, artykułów odpowiadających na podobne pytania oraz stron ofertowych. Zmiana kilku słów czy kolejności zdań zwykle nie wystarczy. Warto różnicować przede wszystkim informacje, intencję, przykłady i wartość oferowaną użytkownikowi.
Linkowanie wewnętrzne
Jeżeli wybraliśmy konkretny URL jako wersję kanoniczną, właśni do niego powinny prowadzić linki wewnętrzne. Google zaleca konsekwentne linkowanie do preferowanego adresu, ponieważ jest to dodatkowy sygnał pomagający zrozumieć strukturę witryny. Nie warto więc ustawiać canonicala na jeden URL i jednocześnie generować w menu, filtrach oraz breadcrumbach linków do jego alternatywnych wersji.
Jak nie stracić mocy linków przy usuwaniu duplikacji treści?
Wykrycie duplicate content to dopiero pierwsza część pracy. Jeżeli dwa duplikujące się adresy zdobywały przez lata linki zewnętrzne, decyzja o usunięciu jednego z nich nie powinna być podejmowana w ciemno. W przeciwnym razie można pozostawić wartościowe backlinki prowadzące przez niepotrzebne przekierowania albo skonsolidować strony w kierunku słabszego URL-a.
Majestic nie jest narzędziem do wykrywania duplicate content. Do tego lepiej wykorzystać crawlery, Siteliner, Copyscape czy Google Search Console. Majestic może być natomiast przydatny na kolejnym etapie: gdy trzeba sprawdzić, jakie linki prowadzą do poszczególnych wersji strony i jak wygląda ich profil.
Przy analizie można uwzględnić przede wszystkim liczbę domen odsyłających, poszczególne backlinki, Trust Flow i Citation Flow. Są to metryki Majestic, a nie czynniki rankingowe publikowane przez Google. Trust Flow pomaga analizować jakość i bliskość zaufanych źródeł w grafie linków, natomiast Citation Flow odnosi się do ilościowej siły profilu.
Którą z duplikujących się podstron wskazać jako kanoniczną?
Załóżmy, że ta sama treść działa pod dwoma adresami:
- example.com/oferta
- example.com/uslugi/oferta
Z technicznego punktu widzenia można wybrać jeden adres i skonsolidować drugi. Zanim to zrobimy, warto jednak sprawdzić oba URL-e w Majestic. Może się okazać, że pierwszy adres zdobył linki z kilkudziesięciu wartościowych domen, a do drugiego prawie nikt z zewnątrz nie linkuje. Takiej informacji nie warto ignorować. W Site Explorer można porównać backlinki, domeny odsyłające oraz Flow Metrics dotyczące konkretnych adresów. Majestic oblicza swoje metryki również na poziomie URL, co pozwala analizować nie tylko domenę jako całość.
Nie oznacza to jednak, że adres z wyższym Trust Flow automatycznie musi zostać canonicalem. Trzeba jeszcze uwzględnić strukturę witryny, intencję strony, użyteczność URL-a i planowane zmiany. Ważne jest natomiast, aby przed konsolidacją wiedzieć, gdzie znajdują się linki, które już udało się zdobyć.
Jak sprawdzić, czy po przekierowaniu 301 moc linków faktycznie się przeniosła?
Po wdrożeniu przekierowania warto wykonać ponowną kontrolę. Najpierw trzeba upewnić się technicznie, że stary URL zwraca właściwe przekierowanie i prowadzi bez zbędnego łańcucha bezpośrednio do strony docelowej. Następnie w Majestic można sprawdzać linki prowadzące do starego adresu oraz obserwować profil strony docelowej. Raporty Site Explorer pozwalają analizować zarówno backlinki, jak i domeny odsyłające, a dane o nowych linkach pomagają śledzić, jak profil rozwija się w czasie.
Szczególną uwagę warto poświęcić najmocniejszym linkom prowadzącym do starego URL-a. Poprawne przekierowanie pozwala konsolidować sygnały, ale jeśli mamy możliwość skontaktowania się z właścicielem wartościowej strony linkującej, dobrze jest poprosić również o zmianę odnośnika na aktualny adres. Ograniczamy w ten sposób zależność od przekierowania i skracamy drogę użytkownika oraz robotów do właściwej strony.
Taką kontrolę szczególnie warto przeprowadzić po migracji HTTP → HTTPS, zmianie www/bez www, usunięciu /index.php, przebudowie struktury URL oraz likwidacji starej wersji serwisu.
Czy skopiowana treść realnie zagraża oryginałowi?
W większości przypadków samo pojawienie się kopii artykułu na przypadkowej, słabej domenie nie powinno prowadzić do paniki. Google zaznacza jednak, że w rzadkich sytuacjach może wybrać jako kanoniczny zewnętrzny adres zawierający skopiowaną bez pozwolenia treść. W przypadku naruszenia praw autorskich zaleca kontakt z właścicielem witryny, a w dalszej kolejności możliwe jest zgłoszenie naruszenia.
Majestic może pomóc ocenić, którym kopiom warto przyjrzeć się w pierwszej kolejności. Można porównać profil linkowy własnej strony i serwisu publikującego kopię: liczbę domen odsyłających, jakość backlinków, Trust Flow, Citation Flow oraz kontekst linkowania. Nie oznacza to, że mocniejszy profil linków automatycznie przesądza o tym, która strona pojawi się wyżej. Ranking zależy od znacznie większej liczby czynników. Analiza backlinków pozwala jednak lepiej ocenić skalę ryzyka i ustalić priorytety.
Jeżeli kopia znajduje się na mocnym, dobrze podlinkowanym serwisie i zaczyna zdobywać własne linki, warto reagować szybciej niż w przypadku automatycznego scraper site bez realnej widoczności i autorytetu.
Jak monitorować profil linków po uporządkowaniu duplikacji?
Po wdrożeniu canonicali i przekierowań dobrze jest wrócić do analizy po pewnym czasie. Warto sprawdzić, czy nowe linki prowadzą już do właściwych URL-i, czy nie pojawiają się kolejne odnośniki do starych adresów oraz czy ważne strony docelowe budują profil zgodnie z oczekiwaniami.
Majestic udostępnia między innymi raporty nowych i utraconych backlinków. Do obserwowania zmian na poziomie domen można wykorzystać również Campaigns, Backlink History i Flow Metric History. To ostatnie narzędzie pozwala analizować zmiany Trust Flow i Citation Flow w czasie. Dzięki temu porządkowanie duplicate content nie kończy się na samym wdrożeniu przekierowania. Można również sprawdzać, czy profil linków rozwija się tam, gdzie faktycznie powinien.
Kiedy duplikacją treści nie trzeba się przejmować?
Nie każdy powtarzający się fragment tekstu wymaga ingerencji. Menu, stopka, podstawowe dane firmy czy elementy nawigacji naturalnie występują na wielu podstronach. Podobnie jest z krótkimi informacjami prawnymi, parametrami technicznymi produktów czy rozsądnie używanymi cytatami.
W sklepie dwa produkty mogą także dzielić część informacji, ponieważ mają te same właściwości techniczne. Najważniejsze pytanie brzmi więc nie „czy na stronie powtarza się jakikolwiek tekst?”, lecz „czy mamy kilka adresów, które z punktu widzenia użytkownika i wyszukiwarki reprezentują praktycznie tę samą stronę?”. Jeżeli różnica między URL-ami jest wyraźna, każdy odpowiada na inną potrzebę i dostarcza własnej wartości, podobieństwo nie musi oznaczać problemu.
Analizuj i reaguj
Duplikacja treści nie oznacza automatycznej kary od Google, ale może utrudniać wybór właściwego URL-a i rozpraszać sygnały SEO. Rozwiązanie zależy od źródła problemu: może to być przekierowanie 301, rel=”canonical”, noindex, poprawa linkowania lub unikalizacja treści. Przy większych zmianach warto też sprawdzić backlinki w Majestic i upewnić się, że prowadzą do właściwych adresów.
FAQ
Czy duplikacja treści szkodzi pozycjonowaniu?
- Może powodować problemy z SEO, ale nie oznacza automatycznej kary. Google może mieć trudność z wyborem preferowanego URL-a, sygnały mogą trafiać do różnych wersji strony, a w dużych serwisach duplikaty mogą powodować niepotrzebne skanowanie adresów.
Czy Google karze za duplicate content?
- Typowa duplikacja treści sama w sobie nie jest naruszeniem zasad Google dotyczących spamu. Problemem mogą natomiast być działania nastawione na manipulowanie wynikami albo publikowanie dużej liczby stron bez wartości dla użytkownika.
Czy canonical zawsze rozwiązuje problem duplikacji?
- Nie. rel=”canonical” jest silnym sygnałem, ale Google może wybrać inny adres, jeżeli pozostałe sygnały są niespójne. Dlatego canonical powinien zgadzać się między innymi z linkowaniem wewnętrznym, przekierowaniami i sitemapą.

- Duplikacja treści – czym jest i jak sobie z nią radzić? - October 1, 2026
- Pozycjonowanie bloga – pierwsze kroki dla każdego - September 16, 2026
- Linki nofollow – czym są i jakie mają znaczenie w pozycjonowaniu? - September 3, 2026